
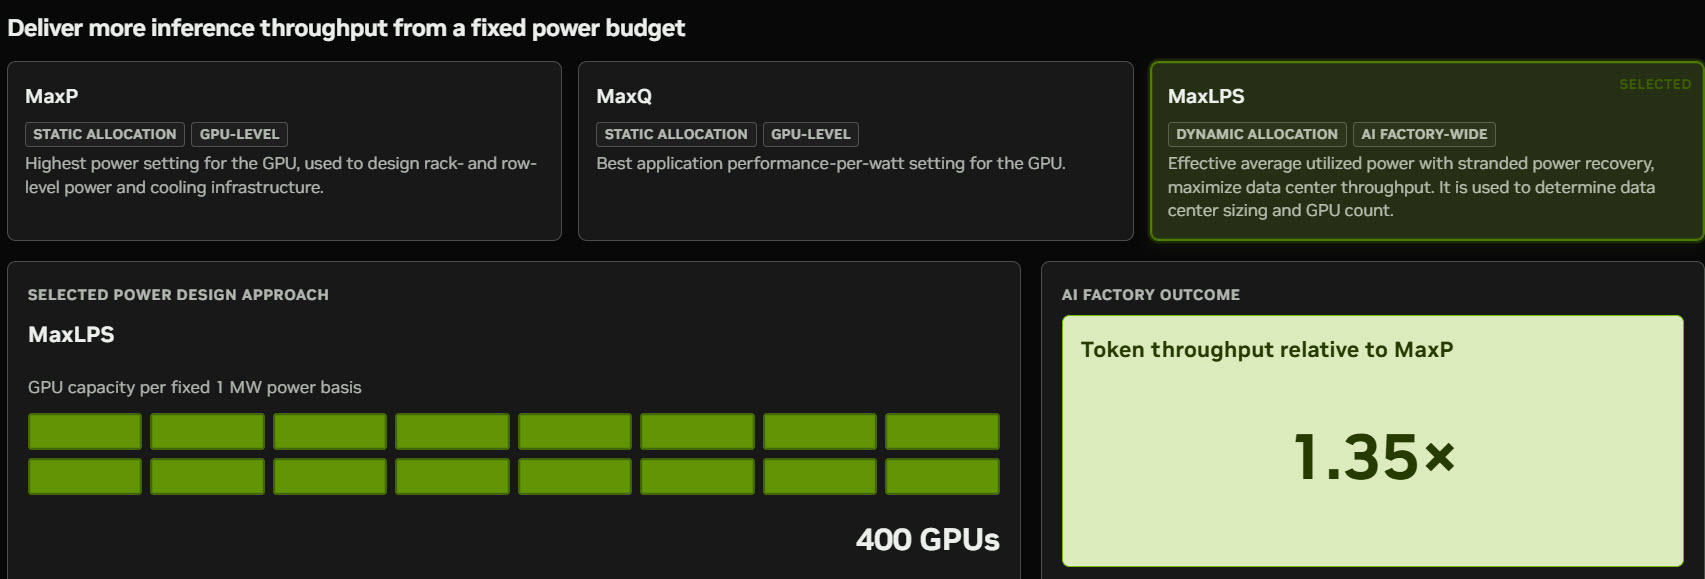
英伟达在AI基础设施峰会上正式发布了面向AI工厂的功耗调度系统DSX MaxLPS。在电力受限的数据中心里,这套系统能让每兆瓦的token吞吐量最高提升40%。它正在改变算力资源的使用方式,也为云基础设施的功耗管理带来了一种新思路。
DSX MaxLPS:把每一度电都花在刀刃上
AI工厂的用电量正变得越来越大。GPU集群一旦满负荷运行,电费和散热压力就会同时飙升。不少数据中心的瓶颈已经不是算力,而是电不够用。DSX MaxLPS的设计初衷很直接:在同样电力预算下,让每一兆瓦电产出尽可能多的token。
所谓“每兆瓦token吞吐量”,指的是数据中心每消耗1兆瓦电力时,每秒能处理或生成的token数量。token是AI模型处理文本的最小单位,这个指标能直观反映电力受限条件下AI数据中心的实际产出能力。过去大家更关注总算力,而现在更看重“一度电的效率”。
Lambda实测:固定功率下吞吐量提升24%
云服务商Lambda做了一组实测。他们把集群限制在固定功率预算内,并部署了DSX MaxLPS。测试集群包含5个机架、19个节点,相比原来16个节点满功率运行的情况,吞吐量从每秒约400万token提升到500万token,增幅达到24%,每瓦性能也提升了23%。
这套系统并不是靠超频硬榨性能,而是动态调整每个节点的功耗分配。正在执行高负载任务的任务,系统会临时分配更多电力;而空闲节点则会主动降低功耗,把省下来的电补给忙碌的节点。
200次电网信号,DSX Flex全自动响应
DSX MaxLPS中还有一个名为DSX Flex的功能,专门应对电网波动。Emerald AI已经将MaxLPS集成到自家的Conductor平台,用于管理电网条件下的数据中心负载。当电网发出降载指令时,DSX Flex会自动调整负载,不需要人工干预。目前这套系统已经累计接收了200次电网信号,每一次都平稳完成响应。
这意味着数据中心不再只是被动用电,而是能主动参与电网调度。对于电力紧缺地区的AI工厂来说,这种“跟着电网节奏呼吸”的能力,比单纯堆硬件更有价值。
Vera Rubin和Groq 3 LPX:算力密度再上台阶
英伟达还公布了新机架方案的潜力。Vera Rubin和Groq 3 LPX机架在相同站点功耗范围内,最多可以增加40%的GPU数量,且在不新增电力线路的前提下,token吞吐量最高可提升35%。
Groq 3 LPX在特定工作负载下的表现更为直接:每位用户每秒可以获得2,529个输出token。这个速度对实时对话、代码生成等场景来说非常重要,用户不必盯着屏幕等待回复。
Vera CPU早期测试:延迟降低5.5倍,查询吞吐量提升3倍
除了功耗调度,Vera CPU的早期测试数据也已经出炉。多家企业跑了真实负载,结果显示性能最高提升1.9倍,吞吐量提升73%,查询任务吞吐量提升3.3倍。
- Redpanda:延迟降低5.5倍,吞吐量提升73%。
- Starburst:查询吞吐量提升3倍。
- Kinetica:分析查询性能提升2.7倍。
这些数据说明,硬件层面的调度和芯片设计正在同步进化。对大多数团队来说,与其自建机房等待电力配额,不如先通过阿里云代理商申请云服务器ECS,把精力集中在业务上。如果需要选型建议,不妨找 易枫顺 - 阿里云官方旗舰级代理商 聊聊,他们的实战经验能帮你少走弯路。
FAQ
Q: DSX MaxLPS到底是什么?
A: 它是英伟达发布的AI工厂功耗调度系统,核心目标是让每兆瓦电力产生更多token。它通过动态调整GPU节点的功耗配额,提升电力受限场景下的数据中心吞吐量,最高可提升40%。
Q: 每兆瓦token吞吐量为什么重要?
A: 随着AI集群越建越大,电力已成为稀缺资源。每兆瓦token吞吐量衡量的是“一度电的产出”,比单纯看总算力更能反映数据中心在电力约束下的实际效率。
Q: DSX Flex功能有什么用?
A: 它可以接收电网的实时信号,自动调整数据中心的用电负荷,无需人工干预。Emerald AI已经使用该功能处理了200次电网信号,对电网稳定和数据中心运行都有助益。
Q: 这项技术对普通企业有什么实际影响?
A: 功耗调度技术有望降低云服务商的算力成本,用户的推理和训练价格也可能因此更亲民。如果企业不想自建机房,选择云服务器ECS是更灵活的路径,用代金券试错成本也不高。
关于易枫顺
深圳市易枫顺网络科技有限公司是阿里云官方旗舰级代理商。提供云服务器ECS、云数据库RDS、对象存储OSS等阿里云全系产品官方特惠折扣与代金券申请,以及多云成本优化、企业上云一站式服务。客服热线:19520841949 - 易枫顺
来源:IT之家
